Ressource
Définition
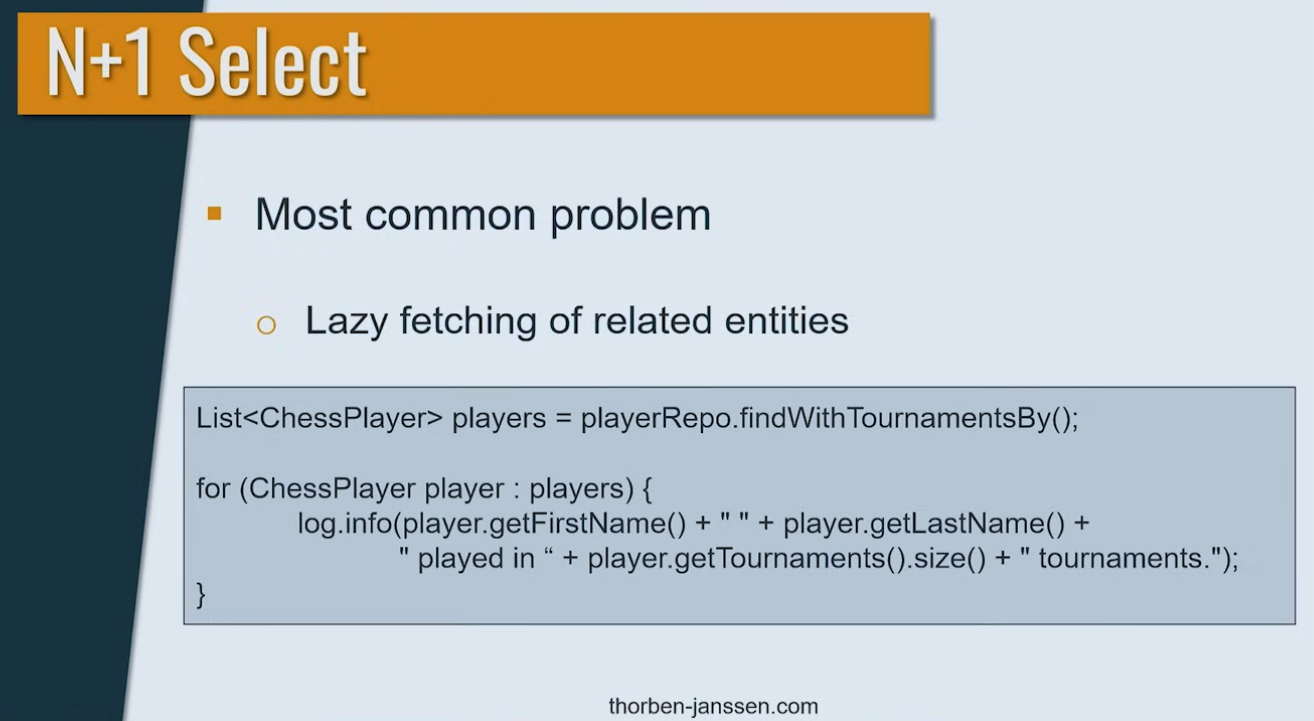
The N+1 query problem happens when the data access framework executed N additional SQL statements to fetch the same data that could have been retrieved when executing the primary SQL query (JOIN)
Exemple
Reprenons la relation Etudiant vers plusieurs Livre (@OneToMany avec une relation LAZY par defaut), et le besoin de parcourir tous les étudiants pour afficher, pour chacun, la liste de ses livres lus.
List<Etudiant> etudiants = em.createQuery("select e from Etudiant e", Etudiant.class)
                             .getResultList();

for (Etudiant e : etudiants) {
    e.getLivresLus().size();    // déclenche une requête à chaque tour de boucle
}
L’implémentation naïve (lazy) produit
SELECT * FROM etudiant;- puis, pour chaque étudiant,
SELECT * FROM livre WHERE etudiant_id = ?;
En d’autres termes nous avons
- x1 : une sélection pour les étudiants
- xN : puis N sélections supplémentaires, où N est le nombre total d’étudiants
- => N+1 requêtes nécessaires
Une seule requête avec jointure aurait suffi
SELECT e.*, l.*
FROM etudiant e
LEFT JOIN livre l ON e.id = l.etudiant_id;
Pourquoi c’est coûteux
Le problème n’est pas le volume de données ramené — il est identique dans les deux cas — mais le nombre d’allers-retours avec la base. Chaque requête paie la latence réseau, le parsing et la planification côté serveur. Avec 500 étudiants, 501 allers-retours remplacent un seul.
Comment le détecter
- activer le log des requêtes SQL et compter (voir Observabilité) ;
- surveiller les traitements où le nombre de requêtes dépend de la taille du résultat.
Les différentes solutions sont détaillées dans l’article suivant.